Das Ergebnis sieht gut aus, klingt sicher und ist trotzdem falsch: Wer KI im Alltag nutzt, kennt dieses Gefühl. Darin steckt ein Muster. Ein Modell erzeugt Antworten auf Basis statistischer Wahrscheinlichkeiten. Dadurch können plausibel klingende Aussagen entstehen, die faktisch falsch sind. Die folgenden Punkte zeigen die Schwächen, die im Marketing besonders häufig auffallen.
Was ist Model Collapse?
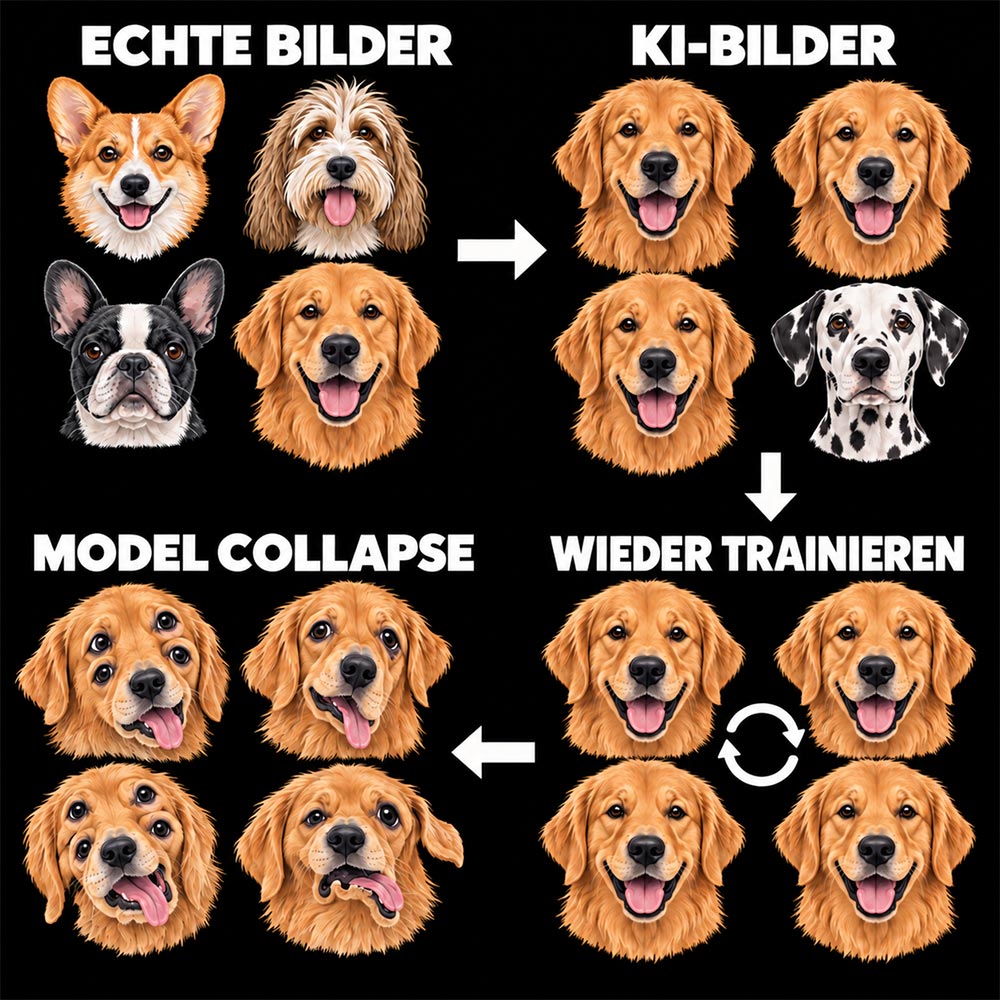
Die Trainingsdaten neuer Modelle stammen längst nicht mehr nur von Menschen. Das Netz füllt sich mit KI-Texten, die wieder im Training der nächsten Generation landen. Wird ein Modell wiederholt mit den Ausgaben seiner Vorgänger trainiert, verstärken sich Fehler von Runde zu Runde. Shumailov haben 2024 in Nature gezeigt, dass Modelle dabei die Fähigkeit verlieren, vielfältige und hochwertige Ergebnisse zu produzieren.
Das kann man sich so vorstellen: ein Foto abfotografieren, das Ergebnis wieder abfotografieren, und so weiter. Mit jeder Runde geht ein Stück Schärfe verloren. In der Sprachtechnologie wird das auch als eine Art Selbstverdauung der Modelle beschrieben. Die Folgen: weniger Präzision, weniger Originalität, mehr Eintönigkeit. Zuerst verschwinden die seltenen, aber korrekten Informationen, also Nischenthemen, kleine Marken und regionale Fakten. Gleichzeitig verbreiten sich Fehlinformationen wie SEO-Mythen so schnell wie noch nie.
- ✅ Fehlinformationen verstärken sich mit jeder Trainingsrunde
- ✅ Seltene, korrekte Informationen gehen verloren
- ✅ Vielfalt und Kreativität der Antworten nehmen ab
- ✅ Ergebnisse wirken gleichförmig oder generisch
Warum klingen KI-Texte alle gleich?
Ein Modell zielt auf den statistischen Durchschnitt seiner Trainingsdaten. Das wahrscheinlichste Ergebnis ist meist auch das konventionellste. Die Folge sieht man überall: KI-Texte, KI-Bilder und KI-Designs ähneln sich immer stärker, dieselben Satzrhythmen, dieselbe Bildsprache.
Fürs Marketing ist das die vielleicht teuerste Schwäche, weil viele Marken von Unterscheidbarkeit leben. Wenn Sie und drei Wettbewerber mit ähnlichen Prompts arbeiten, bekommen Sie austauschbare Ergebnisse. KI ist stark im Durchschnitt und schwach in genau dem, was eine Marke braucht: eine eigene Stimme und eine Haltung, die auch anecken darf. Solche Inhalte liegen neben dem Durchschnitt, und dorthin greift ein Modell von allein nicht. Dieses Phänomen nennt sich auch "Mediocrity Convergence" und beschreibt die Tendenz von KI-Modellen, sich an den statistischen Durchschnitt ihrer Trainingsdaten anzunähern.
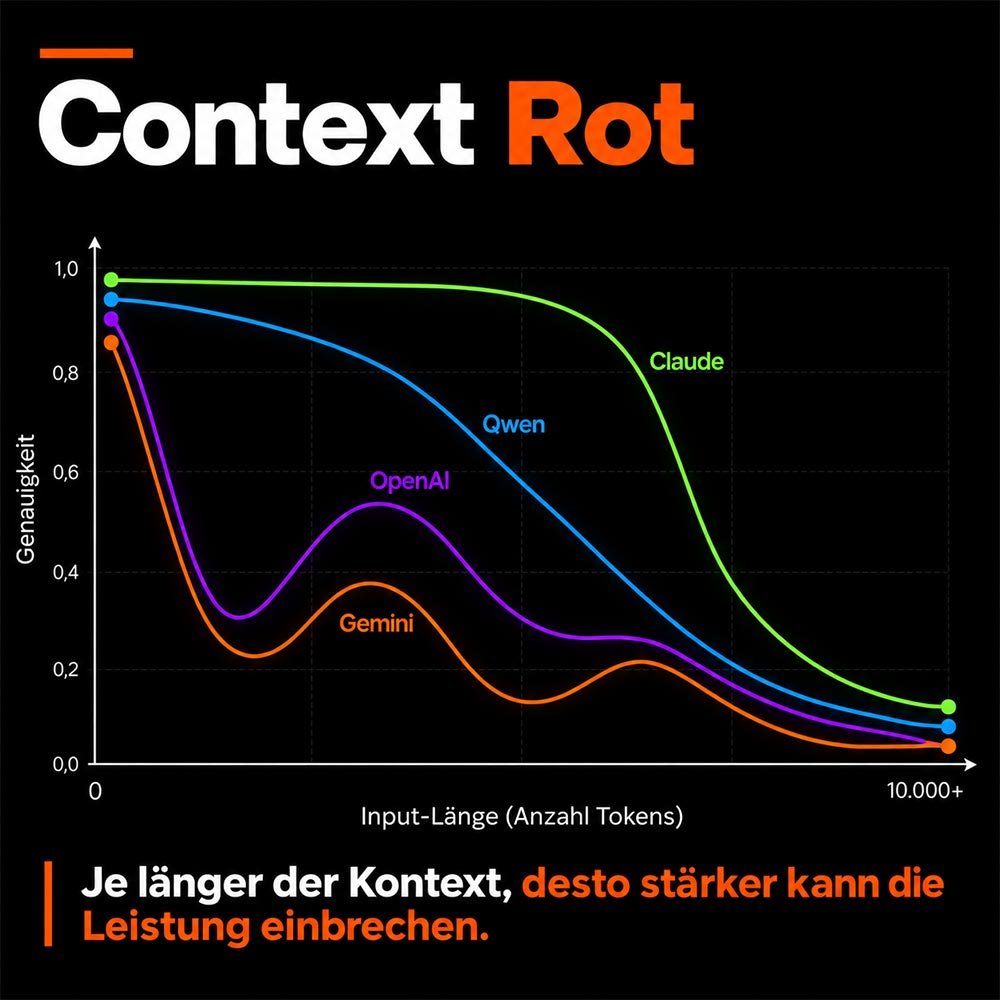
Context Rot: Warum werden KI-Antworten in langen Chats schlechter?
Viele nehmen an, dass mehr Kontext automatisch bessere Antworten bringt. Ab einem gewissen Punkt kippt das. Mit wachsender Länge eines Gesprächs oder Dokuments sinkt die Zuverlässigkeit, ein Effekt, der als Context Rot beschrieben wird. Je mehr Information gleichzeitig im Kontext liegt, desto schwerer fällt es dem Modell, Wichtiges von Unwichtigem zu trennen.
Praktisch heißt das:
- Frühere Anweisungen werden ignoriert
- Details aus der Mitte eines langen Briefings fallen hinten runter
- Nach vielen Nachrichten driftet das Gespräch weg vom Ziel
Besser ist, in kleinen Schritten zu arbeiten, die zentralen Vorgaben bei Bedarf zu wiederholen und das Ergebnis am Ende gegen das Briefing zu prüfen.
Versteht KI Ironie und Zwischentöne?
Sprachmodelle kommen mit klar formulierten Fragen gut zurecht. Schwieriger wird es bei Ironie, Humor, kulturellen Anspielungen oder unausgesprochenen Bedeutungen. Solche Mehrdeutigkeiten menschlicher Kommunikation können von Modellen leicht missverstanden oder falsch eingeordnet werden.
Für Markenkommunikation, die von Tonalität lebt, ist das relevant. Ein Modell trifft den richtigen Ton nicht von allein. Es braucht klare Vorgaben, und am Ende ein menschliches Ohr dafür, ob eine Formulierung sitzt oder danebenliegt.
Warum erfindet KI Fakten?
Ein Sprachmodell sagt Wort für Wort voraus, was als Nächstes plausibel ist. Ob eine Aussage stimmt, prüft es nicht. Deshalb entstehen gut formulierte, selbstbewusste Falschaussagen: erfundene Zahlen, Quellen, die es nie gab, Produktmerkmale, die nicht existieren. Genau das nennt sich Halluzination. Je konkreter und prüfbarer eine Angabe ist, desto höher die Wahrscheinlichkeit, dass ein Modell sie sich zurechtlegt. Fürs Marketing heißt das: Jede Statistik, jedes Zitat, jeder Wettbewerbsvergleich muss ein Mensch prüfen, bevor der Text online geht.
Warum sind KI-Ergebnisse nicht nachvollziehbar?
Ein Modell arbeitet probabilistisch und sagt das wahrscheinlichste nächste Wort voraus. Warum es im Einzelfall genau diese Ausgabe erzeugt, lässt sich nicht vollständig erklären. Selbst die Entwickler können oft nicht sagen, wie ein bestimmtes Ergebnis zustande kam. Man spricht deshalb von einer Blackbox.
Praktisch heißt das zweierlei. Erstens sind die Ausgaben nicht reproduzierbar: Derselbe Prompt kann beim zweiten Mal eine andere Antwort liefern. Zweitens lassen sich Stil und Konsistenz nicht erzwingen. Über längere Texte hinweg weicht ein Modell schon mal vom einmal gesetzten Ton ab. Wer Marken-Konsistenz braucht, muss das Ergebnis kontrollieren.
Warum vertrauen Menschen KI-Inhalten weniger - Algorithm Aversion & Uncanny Valley?
Menschen bewerten dasselbe Ergebnis strenger, sobald sie wissen, dass es von einer KI stammt, auch wenn es objektiv genauso gut ist. Berkeley Dietvorst hat diesen Effekt 2015 als Algorithm Aversion beschrieben: Nach einem sichtbaren Fehler verlieren Menschen das Vertrauen in einen Algorithmus schneller als in einen Menschen, der denselben Fehler macht.
Dazu kommt das Uncanny Valley, ein Begriff von Masahiro Mori aus dem Jahr 1970: Was fast, aber nicht ganz menschlich wirkt, löst Unbehagen aus. Synthetische Stimmen und generierte Gesichter stoßen an diese Grenze. Je mehr generischer KI-Content die Kanäle füllt, desto wertvoller werden die sichtbar menschlichen Signale, etwa das ungeschnittene Gründervideo oder die echte Kundin, die aus Erfahrung spricht.
Macht zu viel KI unser Denken schlechter?
Wer Denkaufgaben dauerhaft an KI abgibt, trainiert sie seltener. Michael Gerlich hat 2025 in der Zeitschrift Societies mit 666 Teilnehmenden einen negativen Zusammenhang zwischen häufiger KI-Nutzung und kritischem Denken gefunden, vermittelt über das sogenannte kognitive Offloading, also das Auslagern von Denkarbeit. Ein höheres Bildungsniveau wirkte in der Studie als Puffer, weil diese Gruppe KI-Ergebnisse eher hinterfragt. Für Marketing-Teams heißt das: KI als Werkzeug einsetzen, nicht als Autopilot. Die Kompetenz, Ergebnisse einzuordnen und zu prüfen, wird wichtiger.
Wofür sollte man KI im Marketing nutzen und wofür nicht?
Aus diesen Grenzen folgt eine Arbeitsteilung:
Gut geeignet ist KI für Menge, Rohentwürfe, Varianten, Strukturvorschläge und die Vorarbeit bei der Recherche. Ein Mensch gehört in die Schleife, sobald es um prüfbare Fakten, um die Positionierung einer Marke, um die eigene Stimme oder um alles geht, was mit einer Behauptung nach außen sichtbar wird. Besonders wichtig wird das bei Themen mit Folgen. Ein Modell ist eine Blackbox, es kann halluzinieren, und es übernimmt keine Verantwortung. Bei rechtlichen Aussagen, bei Gesundheits- oder Finanzthemen und überall dort, wo ein Fehler echte Konsequenzen hat, muss ein Mensch prüfen und Verantwortung übernehmen.
Quellen
- Shumailov, I., Shumaylov, Z., Zhao,Y. et al.: AI models collapse when trained on recursively generated data. Nature 631, 755–759 (2024). https://doi.org/10.1038/s41586-024-07566-y
- Dietvorst, B. J., Simmons, J. P.,Massey, C.: Algorithm Aversion: People Erroneously Avoid Algorithms AfterSeeing Them Err. Journal of Experimental Psychology: General144(1), 114–126 (2015). https://doi.org/10.1037/xge0000033
- Gerlich,M.: AI Tools in Society: Impacts on Cognitive Offloading and the Future ofCritical Thinking. Societies 15(1),6 (2025). https://doi.org/10.3390/soc15010006
- https://www.trados.com/de/resources/is-there-anything-ai-cant-do/
- https://www.data-unplugged.de/blog/was-kann-ki-nicht-chancen
- https://www.makeasmile-media.de/blog/diese-5-dinge-kann-ki-noch-nicht/